外包任务测试中,AI 完成四成,验收仍靠专家
AI 一年内把外包测试完成率拉高到 16.5 倍,可负责打分的 AI 却连专业软件都不会用。
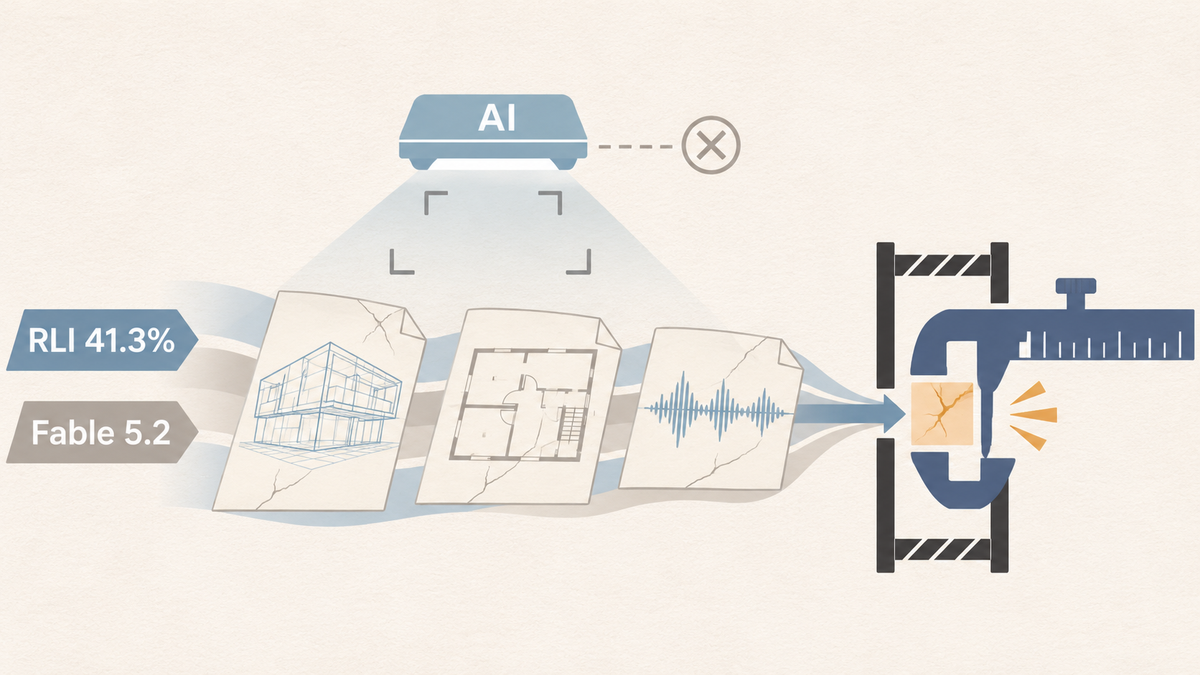
在 240 个总值约 14.4 万美元的 Upwork 项目测试中,AI 完成率一年内升至 41.3%,接近第二名的两倍。但 AI 裁判难以识别交付物的技术缺陷。外包业转向按结果计费,验收正在成为瓶颈。
RLI 基准测试收集了自由职业平台 Upwork 上 240 个已经由人类完成的项目。这些项目平均需要自由职业者投入近 29 小时,涉及视频编辑、CAD 设计、游戏开发和数据分析等工作。
约一年前,基准上线时排名第一的 Manus 只能完成 2.5% 的任务。今年 11 月,Anthropic 的 Fable 5.2 完成率达到 41.3%,约为一年前的 16.5 倍。
但外包客户收到交付物之后,还需要确认其是否合格。
目前,这些交付物仍由受过训练的人类专家评审。研究机构 CAIS 尝试用另一套 AI 系统自动评审,至今未能成功。
在这组测试中,AI 已经能完成四成任务,交付物的验收仍需人类专家。